


최근 인공지능 논쟁에서 “더 이상 데이터 병목은 지능폭발을 막을 수 없다는 주장”이 다시 부상한 것은, 공개 웹 데이터를 대량으로 더 긁어오는 방식만으로 모델 성능을 키우던 단계가 흔들리고 있기 때문이다. 학습에 쓸 만한 인간 작성 데이터는 한계가 있다는 지적이 이어졌지만, 이 주장은 그 한계가 곧 인공지능 발전의 상한선을 뜻하지는 않는다고 본다.
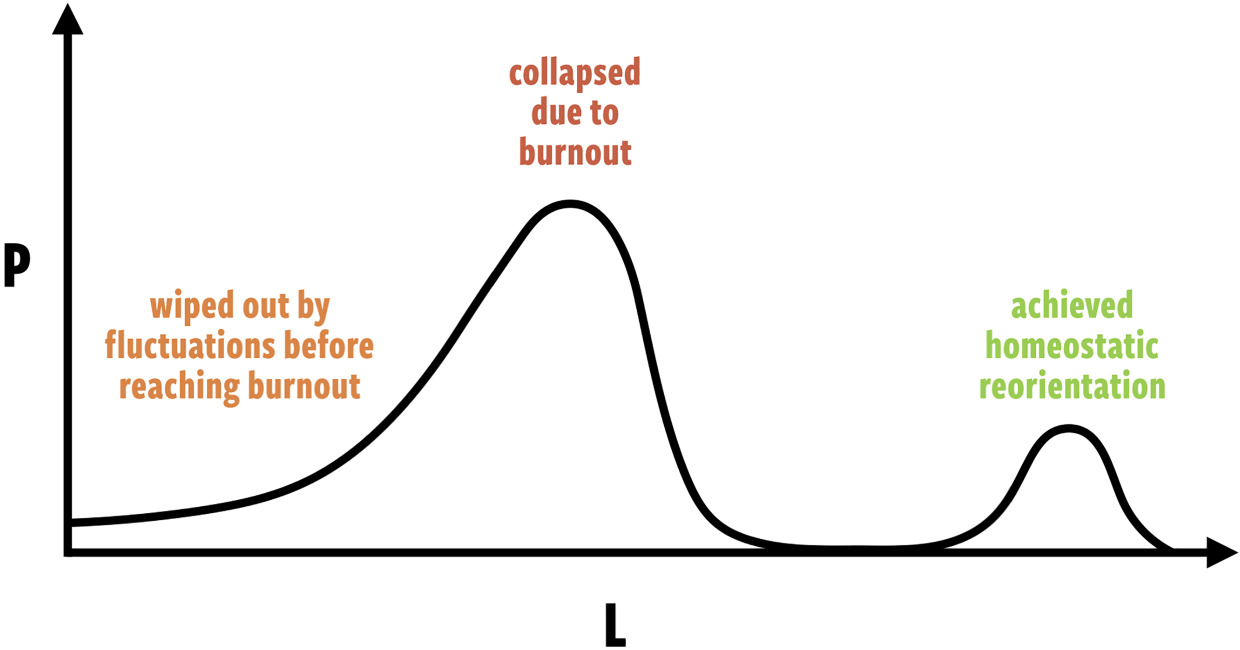
논쟁의 중심에는 인공지능이 직접 만들어 낸 합성 데이터와, 모델이 문제를 풀고 결과를 검증하는 과정에서 쌓이는 학습 신호가 있다. 단순히 문장이나 이미지를 많이 모으는 대신, 수학·코딩·과학 문제처럼 정답 또는 검증 절차가 있는 영역에서 추론 과정을 반복하게 하면 새로운 훈련 재료를 만들어 낼 수 있다는 논리다. 모델이 더 나은 답을 내고, 그 답을 다시 다음 학습의 발판으로 쓰는 순환이 가능하다는 것이다.
여기서 말하는 지능폭발은 성능이 오른 인공지능이 더 효율적인 학습 방법, 도구 사용, 문제 해결 절차를 찾아내며 발전 속도까지 끌어올리는 상황을 가리킨다. 이 관점에서는 부족한 것이 원본 데이터의 절대량이 아니라, 생성된 결과를 걸러내고 보상할 수 있는 검증 환경과 계산 자원이다. 사람이 쓴 고품질 텍스트가 줄어들더라도, 평가 가능한 과제와 시뮬레이션, 실행 결과가 계속 학습 재료를 공급할 수 있다는 주장으로 이어진다.
다만 합성 데이터가 늘어난다고 자동으로 성능이 높아지는 것은 아니다. 잘못된 답을 반복 학습하면 오류가 증폭될 수 있고, 현실 세계의 새로운 사실이나 인간 사회의 복잡한 맥락은 모델 스스로 만들어 낸 데이터만으로 충분히 채우기 어렵다. 그래서 이번 주장은 “데이터 부족 때문에 발전이 멈춘다”는 전망에 대한 반론에 가깝다. 데이터 병목이 사라졌다는 단정이라기보다, 병목의 위치가 데이터 수집에서 검증·추론·연산 능력으로 옮겨갈 수 있다는 문제 제기다.
관심이 커진 이유도 여기에 있다. 인공지능 경쟁의 다음 단계가 더 큰 학습용 말뭉치 확보가 아니라, 모델이 스스로 풀 수 있는 과제를 얼마나 넓히고 그 결과를 얼마나 신뢰성 있게 평가하느냐에 달렸다는 전망과 맞닿아 있기 때문이다. 결국 쟁점은 인공지능이 만들어 낸 지식이 실제 능력 향상으로 이어지는 선순환을 안정적으로 만들 수 있느냐에 있다.
이 주장은 인간이 만든 공개 데이터가 제한돼도 합성 데이터, 검증 가능한 문제 풀이, 도구 사용 결과를 통해 인공지능의 학습 재료를 계속 만들 수 있다는 관점이다. 다만 오류 누적과 현실 지식의 한계가 남아 있어, 데이터 부족의 해소보다 검증 체계와 연산 능력이 새 병목이 될 수 있다는 점이 핵심이다.

 총 개


